ما هو RAG في الذكاء الاصطناعي؟ وكيف يجعل ChatGPT يفهم بياناتك ومعلوماتك الخاصة؟
شهدت نماذج من الذكاء الاصطناعي الوليدي بشكل كبير، وأصبحت قادرة على كتابة النصوص والإجابة عن الأسئلة واختيار المستخدمين في مجموعة واسعة من العازفين، لكن هناك مشكلة تستطيع أن تستطيع الحضور: نموذج لا يعرف بالضرورة المعلومات الخاصة بالمستخدم، كما أن بعض المعلومات لتعيين الطب.
ولم تكن تمتلك شركة تمتلك آلاف المستندات الداخلية، أو مؤسسة لديها قاعدة معرفة خاصة، أو موقعًا تحتوي على معلومات يتم تحديثها يوميًا، ولن يكون من العملي الاعتماد على معرفة النموذج العام وحده.
هنا تحفيز تقنية RAG، وهي اختصار لـ Retrieval-Augmented Generation، أو “التوليد المعزز بالاسترجاع”.
الفكرة ببساطة هي أن النظام لا يعتمد فقط على المعلومات التي تعلمها نموذج الذكاء الاصطناعي أثناء تدريبه، بل نادى أولًا عن المعلومات الأمثل في المصادر الخارجية، ثم يضع هذه المعلومات أمام النموذج حتى يستخدمها في بناء الإجابة.
وبالتالي أصبح الذكاء الاصطناعي من نظام يعتمد بشكل عام على عدم وجود إرادة قوية في اشتراكه في قاعدة معرفة الكتب الإلكترونية.
## ما هو RAG؟
RAG هو أسهل طريقة لبناء تطبيقات ذكاء اصطناعية تجمع بين البحث أو استرجاع المعلومات ونماذج اللغات الجديدة LLMs.
عندما أصبح المستخدم سؤالًا،مصر النظام عن المعلومات الأكثر ارتباطًا بالسؤال داخل قاعدة البيانات أو مجموعة المستندات أو مصدر المعلومات المحددة.
بعد ذلك يتم إرسال السؤال بالمعلومات المسترجعة إلى النموذج اللغوي، ليتم استخدامها لصياغة الإجابة.
وتصف تقنية Microsoft أنها تقارن البحث مع نماذج السياسة الكبيرة والإجابات التي تتفاعل بشكل أكبر مع البيانات التي توفرها للنظام، بينما تعتمد Google Cloud على RAG للجمع بين استرجاع المعلومات والتقدمات الوليدية. 1
## لماذا نحتاج إلى RAG؟
تتعلم اللغة الكبيرة من البيانات الرقمية، ولكن ذلك لا يعني أنها تعرف كل شيء.
هناك ثلاثة أسباب تجعل البيانات الرئيسية مهمة.
### المعلومات الخاصة
قد تكون هناك معلومات لا توجد أصلًا ضمن بيانات التدريب العامة، مثل مستندات الشركة أو ملفات الموظفين أو دليل المنتجات الداخلية.
### المعلومات المتغيرة
بعض المعلومات التركيب، مثل القوائم والقوانين والخزائن والأخبار والبيانات التشغيلية.
### المعلومات المطلوبة
قد تحتاج إلى نموذج يجيب عن أسئلة تتعلق بقاعدة معرفية متخصصة للغاية.
في هذه الحالات يمكن استخدام RAG لحضارة المعلومات بشكل أفضل عندما يطلب منك استبدال نموذج التدريب من جديد على كل تحديث.
## كيف تعمل RAG؟
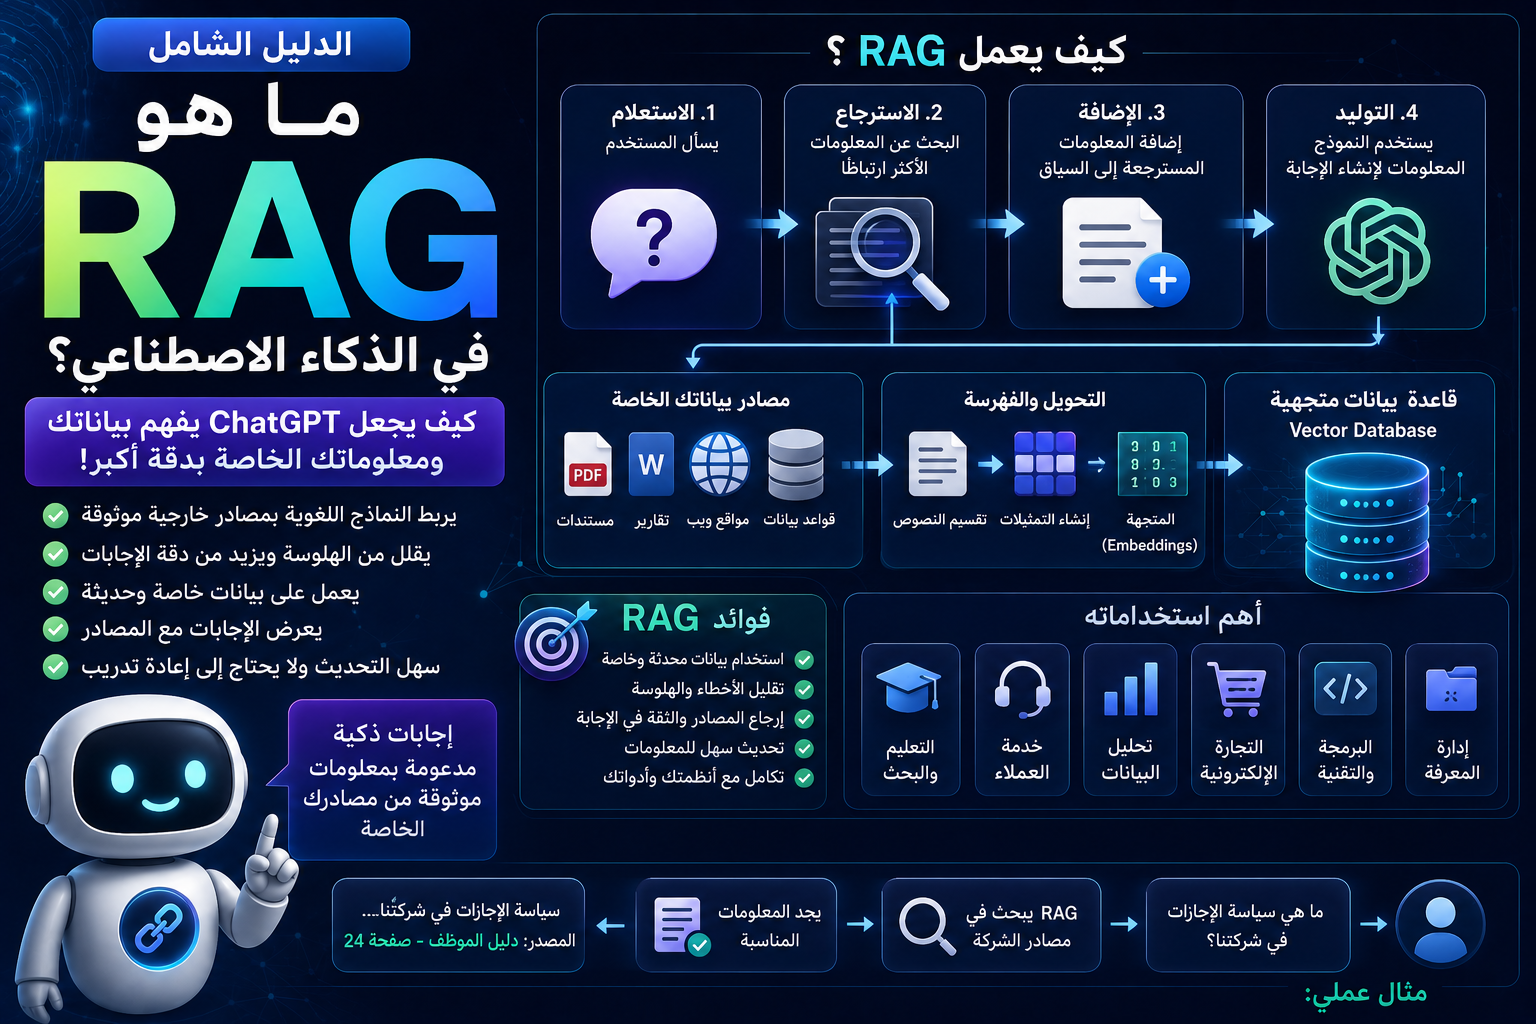
يمكن تبسيط نظام RAG إلى ثلاث مراحل رئيسية:
### المرحلة الأولى: الاسترجاع
متنقل النظام في قاعدة المعرفة عن المعلومات التي بسؤال المستخدم.
### المرحلة الثانية: الإضافة
يتم توفير المعلومات المسترجعة مع السؤال ضمن السياق الذي سيصل إلى النموذج.
### المرحلة الثالثة: التوليد
يستخدم نموذج السؤال المسترجعة لصياغة الإجابة.
هذه هي الفكرة الأساسية التي تقوم بها معظم أجهزة RAG التقليدية. 2
## كيف تتحول البيانات إلى بيانات يمكن RAG البحث فيها؟
قبل أن يستطيع النظام الإجابة عن الأسئلة، يجب أن يمتلك مصادر المعلومات.
إذا كان لديك مئات أو آلاف الملفات، فسترسلها بالكامل إلى النموذج مع كل سؤال سيكون غير عملي.
لذلك يتم تقطيع أجزاء الورقة إلى أجزاء أصغر كثيرًا.
كل جزء يمثل قطعة من المعلومات يمكن استرجاعها عند الحاجة.
وبعد ذلك يتم إنشاء تمثيل داخلي لهذه الجادة باسم التضمين.
ثم حفظ هذه الخيارات في نظام يسمح بالبحث عنها.
ما هي Embeddings؟
الـ Embedding هو تمثيل رقمي للمعلومات.
بدل التعامل مع النص باعتباره مجموعة كلمات فقط، يحول النظام المحتوى إلى مجموعة من الأرقام تمثل خصائصه الدلالية.
يسمح ذلك بمقارنة السؤال مع أجزاء مختلفة من قاعدة المعرفة والبحث عن المحتوى الأقرب من حيث المعنى.
وهذا أحد الأسباب التي تجعل البحث الدلالي مهمًا في تطبيقات RAG الحديثة.
ما هي قاعدة البيانات المتجهية Vector Database؟
تستخدم بعض أنظمة RAG قواعد بيانات متجهية لتخزين الـ Embeddings وتنفيذ عمليات البحث عن التشابه.
عندما يطرح المستخدم سؤالًا، يتم تحويل السؤال أيضًا إلى تمثيل رقمي، ثم يبحث النظام عن أجزاء المحتوى الأقرب إليه.
لكن RAG لا يعتمد بالضرورة على البحث المتجهي وحده.
يمكن استخدام البحث بالكلمات المفتاحية أو البحث الدلالي أو مزيج بين الاثنين، وهو ما يسمى Hybrid Search. 3
ما الفرق بين البحث بالكلمات والبحث الدلالي؟
البحث بالكلمات يبحث عن تطابقات مباشرة أو قريبة بين الكلمات.
أما البحث الدلالي فيحاول فهم العلاقة في المعنى.
على سبيل المثال، قد يبحث المستخدم عن:
“كيف يمكنني استعادة حسابي؟”
بينما يحتوي المستند على:
“إجراءات استرجاع الحساب بعد فقدان كلمة المرور.”
رغم اختلاف الكلمات، فإن المعنى متقارب.
وهنا يمكن للبحث الدلالي أن يكون أكثر فائدة.
ما هو Hybrid Search؟
البحث الهجين يجمع عادةً بين أكثر من أسلوب لاسترجاع المعلومات.
يمكن للنظام استخدام البحث بالكلمات المفتاحية إلى جانب البحث المتجهي، ثم ترتيب النتائج للحصول على أفضل مجموعة من المقاطع المناسبة.
هذا الأسلوب مفيد لأن البحث بالكلمات قد يكون قويًا في الأسماء والأرقام والمصطلحات الدقيقة، بينما البحث الدلالي قد يكون أفضل في فهم المعنى العام.
هل RAG يمنع الهلوسة؟
لا يمكن القول إن RAG يمنع الهلوسة بشكل كامل.
لكنه يمكن أن يساعد في تقليلها عندما يحصل النموذج على معلومات موثوقة ومرتبطة بالسؤال.
إذا كانت المعلومات المسترجعة خاطئة أو غير مكتملة، فقد ينتج النموذج إجابة غير دقيقة رغم استخدام RAG.
ولهذا فإن جودة الاسترجاع وجودة قاعدة المعرفة والتعليمات الموجهة للنموذج كلها عوامل مهمة. 4
ماذا يحدث إذا استرجع النظام المعلومات الخطأ؟
هذه من أهم مشكلات RAG.
تخيل أن قاعدة المعرفة تحتوي على عشرة آلاف مستند، لكن السؤال يحتاج إلى ثلاثة مستندات فقط.
إذا استرجع النظام مستندات غير مرتبطة، فإن النموذج سيبني إجابته على سياق غير مناسب.
وقد تبدو الإجابة صحيحة لغويًا لكنها تكون خاطئة من الناحية الموضوعية.
لذلك لا يكفي بناء قاعدة بيانات كبيرة؛ يجب بناء نظام استرجاع جيد.
ما أهمية تقسيم المستندات إلى Chunks؟
تقسيم المستندات خطوة حساسة.
إذا كانت الأجزاء كبيرة جدًا، فقد يحتوي كل جزء على معلومات كثيرة غير مرتبطة بالسؤال.
وإذا كانت صغيرة جدًا، فقد يتم فصل المعلومات التي تحتاج إلى بعضها لفهم المعنى.
لذلك يجب اختيار استراتيجية تقسيم مناسبة لطبيعة البيانات.
وقد تختلف الاستراتيجية المناسبة للمقالات عن العقود أو الأكواد البرمجية أو الجداول أو الوثائق التقنية.
هل يمكن استخدام RAG مع ملفات PDF؟
نعم.
يمكن بناء نظام RAG يعتمد على ملفات PDF، بشرط استخراج محتواها بصورة مناسبة.
وإذا كانت الملفات تحتوي على جداول أو صور أو مخططات، فقد تحتاج عملية معالجة أكثر تعقيدًا.
وهذا يعني أن جودة نظام RAG لا تعتمد على نموذج اللغة وحده، بل تبدأ منذ مرحلة إدخال البيانات.
هل يمكن استخدام RAG مع موقع إلكتروني؟
نعم.
يمكن إنشاء قاعدة معرفة تعتمد على محتوى موقع إلكتروني.
يمكن للنظام جمع الصفحات أو المقالات أو المستندات، ثم تجهيزها للبحث.
بعد ذلك يستطيع المستخدم طرح سؤال، ويبحث النظام في المحتوى المرتبط بالموقع قبل إنشاء الإجابة.
وهذا يمكن أن يكون مفيدًا جدًا في مواقع الشركات والمراكز التعليمية والمواقع الإخبارية وقواعد المعرفة.
كيف يمكن استخدام RAG في المواقع الإخبارية؟
يمكن استخدام RAG لبناء محرك بحث ذكي داخل الموقع.
بدل البحث التقليدي عن كلمة محددة، يستطيع المستخدم طرح سؤال مثل:
“ما أبرز المقالات التي نشرها الموقع حول الذكاء الاصطناعي خلال الأشهر الماضية؟”
فيبحث النظام في أرشيف الموقع ويجمع المقالات المناسبة ثم يقدم ملخصًا أو إجابة مستندة إلى المحتوى المسترجع.
لكن يجب الانتباه إلى حقوق المحتوى ودقة الاسترجاع وطريقة عرض المصادر.
كيف يمكن استخدام RAG في الشركات؟
يمكن للشركة إنشاء مساعد ذكي يعتمد على مستنداتها الداخلية.
مثل:
سياسات الموارد البشرية.
أدلة الموظفين.
كتيبات المنتجات.
الوثائق التقنية.
الأسئلة الشائعة.
العقود والإجراءات.
بدل أن يسأل الموظف عشرات الأقسام عن معلومة معينة، يمكنه طرح السؤال على النظام، الذي يبحث في قاعدة المعرفة ثم يقدم إجابة مبنية على الوثائق المتاحة.
كيف يمكن استخدام RAG في خدمة العملاء؟
يمكن ربط نظام RAG بقاعدة معرفة الشركة.
عندما يطرح العميل سؤالًا، يبحث النظام في أدلة المنتجات والأسئلة الشائعة وسياسات الشركة، ثم يولد إجابة اعتمادًا على المعلومات المسترجعة.
ويمكن أن تكون الإجابة أكثر فائدة من إجابة تعتمد فقط على المعرفة العامة للنموذج.
ما علاقة RAG بـChatGPT؟
ChatGPT هو تطبيق أو خدمة تعتمد على نماذج ذكاء اصطناعي، بينما RAG هو أسلوب هندسي لبناء أنظمة ذكاء اصطناعي تسترجع المعلومات الخارجية وتستخدمها أثناء توليد الإجابات.
لذلك يمكن استخدام نموذج لغوي مشابه للنماذج التي تدعم تطبيقات المحادثة ضمن نظام RAG.
الفكرة ليست أن RAG هو نموذج منافس لـChatGPT، بل أنه طريقة لتزويد نموذج اللغة بسياق خارجي مناسب.
هل RAG يعني تدريب النموذج؟
لا.
هذه نقطة مهمة جدًا.
في نظام RAG التقليدي، لا تحتاج إلى إعادة تدريب النموذج في كل مرة تضيف فيها مستندًا جديدًا.
بدل ذلك، يتم تحديث قاعدة المعرفة أو الفهرس الذي يبحث فيه النظام.
ثم عندما يأتي سؤال جديد، يسترجع النظام المعلومات الجديدة ويضعها ضمن السياق.
وهذا يختلف عن Fine-Tuning الذي يتضمن تعديل النموذج باستخدام بيانات تدريب إضافية. 5
ما الفرق بين RAG وFine-Tuning؟
RAG
يضيف معلومات خارجية إلى السياق وقت الإجابة.
مناسب عندما تتغير البيانات باستمرار.
مناسب للبيانات الخاصة.
يسمح بإرجاع المصادر في بعض التصميمات.
لا يحتاج عادةً إلى إعادة تدريب النموذج عند كل تحديث للمعلومات.
Fine-Tuning
يعدل النموذج نفسه باستخدام بيانات تدريب إضافية.
يمكن أن يكون مناسبًا لتغيير أسلوب النموذج أو تحسين أدائه في مهمة معينة.
لكنه ليس الطريقة المثالية دائمًا لإعطاء النموذج قاعدة معرفة تتغير باستمرار.
ولهذا قد يستخدم النظام RAG أو Fine-Tuning أو الاثنين معًا بحسب الهدف.
ما مكونات نظام RAG؟
يمكن أن يتكون النظام من عدة أجزاء.
مصدر البيانات
وهو المكان الذي تأتي منه المعلومات.
قد يكون ملفات أو قاعدة بيانات أو موقعًا أو نظامًا داخليًا.
معالجة البيانات
يتم تنظيف البيانات وتقسيمها وتجهيزها.
Embedding Model
يحول المحتوى إلى تمثيلات رقمية يمكن استخدامها في البحث الدلالي.
Index
ينظم البيانات بحيث يمكن استرجاع المعلومات بسرعة.
Retriever
يبحث عن المقاطع الأكثر ارتباطًا بالسؤال.
Reranker
قد يستخدم النظام مرحلة إضافية لإعادة ترتيب النتائج وفق مدى ملاءمتها.
نموذج اللغة
يستخدم السؤال والسياق المسترجع لإنشاء الإجابة.
نظام التقييم
يساعد على قياس جودة الاسترجاع والإجابة واكتشاف نقاط الضعف.
ما هو Reranking؟
بعد البحث الأولي قد يحصل النظام على مجموعة من النتائج.
لكن ليس كل النتائج متساوية في الأهمية.
يمكن استخدام Reranker لإعادة ترتيب النتائج وتحديد المقاطع الأكثر صلة بالسؤال قبل إرسالها إلى نموذج اللغة.
وهذا يمكن أن يحسن جودة السياق الذي يحصل عليه النموذج.
ما هو Agentic RAG؟
تطورت أنماط RAG الحديثة لتتجاوز فكرة تنفيذ بحث واحد لكل سؤال.
في Agentic RAG يمكن استخدام نموذج أو وكيل لتقسيم السؤال المعقد إلى عدة استعلامات أصغر، ثم تنفيذ عمليات بحث متعددة وربط النتائج معًا.
مثلًا إذا سأل المستخدم:
“قارن بين أداء الشركة في الربع الأول والثاني، واشرح أسباب التغير.”
قد يحتاج النظام إلى البحث عن تقارير متعددة بدل تنفيذ عملية استرجاع واحدة.
وتوضح Microsoft أن الاسترجاع الوكيلي يمكن أن يستخدم التخطيط للاستعلامات وتنفيذ عدة عمليات بحث بالتوازي وترتيب النتائج لتقديم سياق أكثر ملاءمة. 6
هل Agentic RAG أفضل دائمًا؟
ليس بالضرورة.
إذا كان السؤال بسيطًا، فقد يكون RAG التقليدي أسرع وأقل تكلفة.
أما الأسئلة المعقدة التي تحتاج إلى البحث في مصادر متعددة، فقد تستفيد من الاسترجاع الوكيلي.
لذلك يجب اختيار التصميم بناءً على طبيعة المهمة بدل استخدام أكثر بنية تعقيدًا لمجرد أنها أحدث.
ما فوائد RAG؟
استخدام البيانات الخاصة
يسمح بربط نماذج الذكاء الاصطناعي بمعلومات المؤسسة أو المستخدم.
تحديث المعلومات
يمكن تحديث قاعدة المعرفة دون إعادة تدريب النموذج بالكامل.
تحسين الارتباط بالسياق
يحصل النموذج على معلومات مرتبطة بالسؤال بدل الاعتماد فقط على معرفته العامة.
دعم المصادر
يمكن تصميم النظام ليعرض المستندات أو الروابط التي استند إليها.
تقليل بعض الأخطاء
يمكن أن يساعد الاسترجاع الجيد على تقليل الإجابات غير المستندة إلى معلومات حقيقية.
توفير التخصيص
يمكن إنشاء نظام ذكاء اصطناعي مخصص لمجال أو مؤسسة معينة.
ما عيوب RAG؟
جودة الاسترجاع
إذا لم يجد النظام المعلومات المناسبة، فلن يستطيع النموذج استخدامها.
جودة البيانات
البيانات القديمة أو الخاطئة ستؤثر في الإجابة.
التكلفة
البحث والفهرسة والتخزين واستخدام النموذج قد تزيد التكلفة.
زمن الاستجابة
إضافة مرحلة البحث قد تزيد زمن الإجابة.
إدارة الصلاحيات
يجب التأكد من أن المستخدم لا يستطيع استرجاع معلومات غير مصرح له بالوصول إليها.
استهلاك السياق
إرسال عدد كبير من المقاطع إلى النموذج قد يستهلك مساحة السياق ويزيد التكلفة.
وتشير وثائق Microsoft إلى أن أنظمة RAG قد تواجه مشكلات في جودة الاسترجاع والهلوسة وزمن الاستجابة وحجم السياق، إضافة إلى مخاطر تسريب البيانات إذا لم تكن صلاحيات الوصول مضبوطة. 7
هل RAG مناسب للبيانات الحساسة؟
يمكن استخدامه في البيئات التي تحتوي على بيانات حساسة، لكن ذلك يحتاج إلى تصميم أمني مناسب.
المشكلة ليست فقط في النموذج.
يجب أيضًا حماية قاعدة المعرفة ونظام الفهرسة والصلاحيات وعمليات تسجيل الوصول.
إذا تمكن مستخدم من استرجاع مستند لا يملك صلاحية الاطلاع عليه، فقد يكشف النظام معلومات حساسة حتى لو كانت الإجابة نفسها صحيحة.
لذلك يجب ربط الاسترجاع بسياسات الوصول المناسبة.
كيف يتم تقييم نظام RAG؟
لا يكفي أن تسأل النظام بضعة أسئلة وتقول إنه يعمل.
يمكن تقييمه على مستويين رئيسيين.
تقييم الاسترجاع
هل استرجع النظام المستندات الصحيحة؟
تقييم الإجابة
هل استخدم النموذج المعلومات المسترجعة بصورة صحيحة؟
وتوجد أطر تقييم متخصصة تقيس جودة الاسترجاع ومدى ارتباط النتائج بالسؤال، لأن ضعف الاسترجاع يمكن أن يصبح عنق الزجاجة في النظام بأكمله. 8
كيف تبني نظام RAG بسيطًا؟
يمكن تصور العملية كالتالي:
الخطوة الأولى
اجمع مصادر المعلومات التي تريد أن يعتمد عليها النظام.
الخطوة الثانية
نظف البيانات وأزل المحتوى غير المفيد.
الخطوة الثالثة
قسم المستندات إلى أجزاء مناسبة.
الخطوة الرابعة
أنشئ Embeddings لهذه الأجزاء.
الخطوة الخامسة
خزن التمثيلات في نظام بحث مناسب.
الخطوة السادسة
عندما يطرح المستخدم سؤالًا، أنشئ Embedding للسؤال.
الخطوة السابعة
ابحث عن أكثر المقاطع ارتباطًا.
الخطوة الثامنة
أرسل السؤال والمقاطع المسترجعة إلى نموذج اللغة.
الخطوة التاسعة
اعرض الإجابة مع المصادر عندما يكون ذلك ممكنًا.
هل يحتاج RAG إلى قاعدة بيانات متجهية؟
ليس دائمًا.
يمكن بناء أنظمة استرجاع باستخدام البحث بالكلمات أو قواعد بيانات تقليدية أو محركات بحث أو أنظمة هجينة.
لكن قواعد البيانات المتجهية أصبحت شائعة في تطبيقات RAG التي تعتمد على البحث الدلالي.
وتوضح Google Cloud أن أنظمة RAG الحديثة قد تستخدم البحث المتجهي أو البحث بالكلمات أو البحث الهجين، إضافة إلى إعادة ترتيب النتائج. 9
هل يمكن استخدام RAG مع قواعد البيانات العادية؟
نعم.
يمكن بناء أنظمة تسترجع معلومات من قواعد بيانات منظمة، خصوصًا عندما تكون البيانات عبارة عن سجلات أو أرقام أو معلومات منظمة.
وفي بعض التطبيقات يمكن الجمع بين البحث في المستندات والبحث في قواعد البيانات.
وهذا يسمح للنظام بالتعامل مع البيانات غير المنظمة والمنظمة ضمن المهمة نفسها.
ما الفرق بين RAG ومحرك البحث؟
محرك البحث يركز أساسًا على العثور على المعلومات وعرض النتائج.
أما RAG فيضيف خطوة أخرى: استخدام المعلومات المسترجعة لتوليد إجابة بلغة طبيعية.
يمكن النظر إلى محرك البحث باعتباره جزءًا من نظام RAG في بعض التصميمات.
لكن RAG ليس مجرد محرك بحث؛ بل بنية تجمع الاسترجاع مع نموذج توليدي.
هل يمكن استخدام RAG مع الصور والصوت والفيديو؟
نعم، حسب تصميم النظام والنماذج المستخدمة.
يمكن إنشاء تمثيلات لأنواع مختلفة من البيانات، ثم استرجاع المعلومات ذات الصلة.
وهذا يفتح الباب أمام أنظمة RAG متعددة الوسائط، حيث يمكن البحث عن المعلومات في الصور أو الصوت أو الفيديو إلى جانب النص.
وهنا يظهر ارتباط RAG بالمفهوم الذي تناولناه في المقال السابق عن الذكاء الاصطناعي متعدد الوسائط.
ما مستقبل RAG؟
من المرجح أن يستمر RAG في التطور مع تطور نماذج الذكاء الاصطناعي ومحركات البحث والأنظمة الوكيلية.
وقد تنتقل الأنظمة من استعلام واحد إلى عمليات استرجاع أكثر ذكاءً، تفهم سياق المحادثة وتعيد صياغة الأسئلة وتنفذ عمليات بحث متعددة.
كما يمكن أن يصبح الدمج بين البحث الدلالي والكلمات المفتاحية وإعادة الترتيب والتخطيط الوكيلي جزءًا أساسيًا من تطبيقات الذكاء الاصطناعي المؤسسية.
والهدف النهائي ليس مجرد جعل النموذج “يعرف أكثر”، وإنما جعله يستخدم المعلومات المناسبة في اللحظة المناسبة.
هل سيصبح RAG جزءًا أساسيًا من تطبيقات الذكاء الاصطناعي؟
بالنسبة للأنظمة التي تحتاج إلى العمل مع بيانات خاصة أو متغيرة باستمرار، يبدو RAG من الأساليب المهمة جدًا.
فبدل محاولة تخزين كل معلومة داخل النموذج نفسه، يمكن الاحتفاظ بالمعرفة في مصادر خارجية وجعل النموذج يسترجع منها ما يحتاج إليه.
وهذا الفصل بين “النموذج” و”المعرفة الخارجية” يجعل تحديث المعلومات وإدارتها أكثر مرونة في كثير من التطبيقات.
الخلاصة
RAG ليس نموذج ذكاء اصطناعي جديدًا بقدر ما هو طريقة لبناء تطبيقات أكثر ارتباطًا بالبيانات.
فكرته الأساسية بسيطة: ابحث أولًا عن المعلومات المناسبة، ثم قدمها إلى نموذج الذكاء الاصطناعي، وبعد ذلك اجعل النموذج يستخدمها لصياغة الإجابة.
لكن بناء نظام RAG عالي الجودة ليس مجرد إنشاء قاعدة بيانات وربطها بنموذج لغوي.
جودة البيانات، وطريقة تقسيم المستندات، والـEmbeddings، ونظام البحث، وإعادة ترتيب النتائج، وتصميم التعليمات، وإدارة الصلاحيات، وطرق التقييم كلها تؤثر في النتيجة.
كما أن RAG لا يلغي الأخطاء أو الهلوسة بصورة كاملة، لأن النموذج يظل قادرًا على إنتاج إجابة غير دقيقة إذا كانت المعلومات المسترجعة ناقصة أو غير مناسبة.
ومع ظهور Agentic RAG، أصبحت أنظمة الاسترجاع قادرة على التعامل مع الأسئلة المعقدة من خلال تقسيمها إلى عمليات بحث متعددة وربط نتائجها.
ولهذا فإن فهم RAG أصبح مهمًا لأي شخص يريد فهم الطريقة التي ستعمل بها تطبيقات الذكاء الاصطناعي الحديثة مع البيانات الخاصة والمؤسسية.
وفي المستقبل قد لا يكون السؤال الأساسي: “ما الذي يعرفه نموذج الذكاء الاصطناعي؟”، وإنما: “إلى أي معلومات يستطيع الوصول إليها، وكيف يختار المعلومات الصحيحة، وكيف يستخدمها؟”
الأسئلة الشائعة
ما هو RAG؟
RAG هو اختصار Retrieval-Augmented Generation، وهي تقنية تجمع بين استرجاع المعلومات من مصادر خارجية وقدرات نماذج اللغة التوليدية لإنتاج إجابات مبنية على سياق مسترجع.
ماذا يعني Retrieval-Augmented Generation؟
يعني التوليد المعزز بالاسترجاع، أي أن النظام يسترجع معلومات مرتبطة بالسؤال ثم يستخدمها النموذج عند إنشاء الإجابة.
هل RAG نموذج ذكاء اصطناعي؟
لا، RAG هو نمط أو بنية لتصميم تطبيقات الذكاء الاصطناعي، ويمكن أن يستخدم نماذج لغة مختلفة داخله.
هل RAG هو نفسه ChatGPT؟
لا. ChatGPT خدمة تعتمد على نماذج ذكاء اصطناعي، بينما RAG تقنية يمكن استخدامها لبناء تطبيقات تستفيد من نماذج اللغة مع بيانات خارجية.
هل RAG يحتاج إلى تدريب النموذج؟
ليس بالضرورة. في RAG التقليدي يمكن إضافة أو تحديث المعرفة في قاعدة البيانات دون إعادة تدريب نموذج اللغة نفسه.
ما الفرق بين RAG وFine-Tuning؟
RAG يسترجع المعلومات الخارجية أثناء الإجابة، بينما Fine-Tuning يعدل النموذج باستخدام بيانات تدريب إضافية لتحسين سلوك أو أداء معين.
هل RAG يمنع الهلوسة؟
لا يمنعها بشكل كامل، لكنه يمكن أن يقلل بعض الأخطاء عندما يتم استرجاع معلومات دقيقة ومرتبطة بالسؤال.
ما هي Embeddings؟
هي تمثيلات رقمية للمعلومات تساعد الأنظمة على مقارنة المحتوى من حيث التشابه الدلالي.
ما هي Vector Database؟
هي قاعدة بيانات أو نظام تخزين مصمم للتعامل مع المتجهات والبحث عن العناصر المتشابهة، وتستخدم في العديد من تطبيقات RAG.
هل RAG مناسب للشركات؟
نعم، خصوصًا للشركات التي تريد بناء مساعدين يعتمدون على الوثائق الداخلية أو قواعد المعرفة أو البيانات المتخصصة.
هل يمكن استخدام RAG مع ملفات PDF؟
نعم، ويمكن استخدامه للبحث في محتوى ملفات PDF بعد استخراجها ومعالجتها بصورة مناسبة.
هل يمكن استخدام RAG مع المواقع الإلكترونية؟
نعم، يمكن تجهيز محتوى الموقع وفهرسته ثم استخدامه كمصدر معرفة لنظام ذكاء اصطناعي.
ما هو Agentic RAG؟
هو أسلوب أكثر تقدمًا من RAG يستخدم القدرات التحليلية لتقسيم الأسئلة المعقدة إلى علامات متعددة لمشاريع الشباب واسترجاع أكثر ذكاءً.
### هل Agent RAG أفضل من RAG التقليدي؟
ليس دائمًا. قد يكون RAG الأصلي أسرع وأبسط للمهام المباشرة، بينما قد يكون Agent RAG مفيدًا في الأسئلة المعقدة التي تحتاج إلى مصادر بحث متعددة.
### هل يمكن استخدام RAG مع الصور؟
نعم، يمكن بناء قاعدة بيانات بحثية مختلفة، وفقًا للتقدمات والأدوات المستخدمة.
### ما أهم مشكلة في RAG؟
من أكبر مشاكل الاسترجاع؛ وقد حصل النموذج على معلومات غير مفيدة أو ناقصة، وقد وصلت المشكلة إلى الإجابة النهائية.
### هل RAG هو مستقبل الذكاء الاصطناعي؟
يعد من أهم مصادر إنشاء تطبيقات ذكاء صناعي تعتمد على بيانات خاصة أو حديثة، ومن ثم يبدأ تطويره مع الوكلاء وحركات البحث والنماذج المتعددة الوسائط.